一个模拟弯道:你总在150米牌开始重刹
先说明,本节和后文的赛道、圈数、距离、车速都是为了说明机制而设定的模拟示例,不是真实玩家数据。
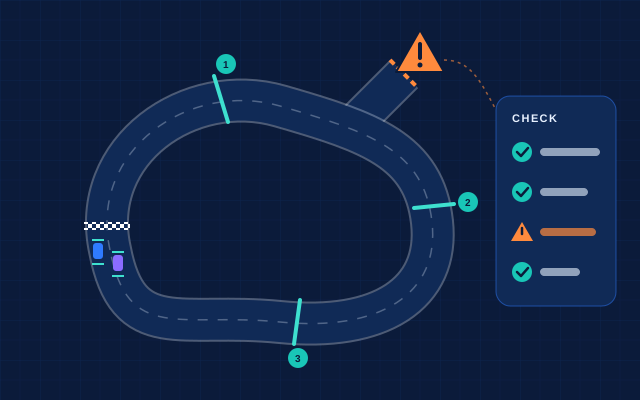
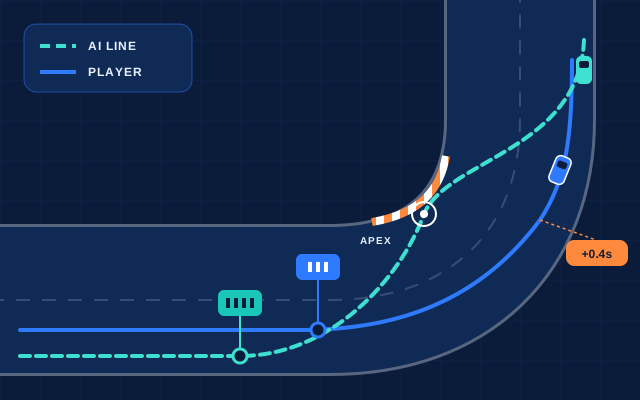
虚构赛道“港湾环线”的第3弯是一个接近180度的发卡弯,入弯前的直道末端车速约220km/h。某位玩家过去20圈里,有17圈在150米标志牌附近开始重刹,2圈晚到120米,1圈早到170米。出弯时他习惯先向外侧放宽,再慢慢收回,全油门比理想时机晚约0.3秒。
对一个只按固定赛车线跑的AI来说,这些信息不存在:它按自己的理想刹车点刹车,和玩家相遇时套用通用超车逻辑。学会刹车习惯的AI多了一张表:在第3弯,这个玩家大概率会怎么做。
AI真正学到的不是一个数字,而是一份分弯道的行为分布
“他在150米刹车”这句话太粗。有用的玩家模型至少要记录下面几项,并且按情境切开:
| 字段 | 模拟值(第3弯) | AI可以拿来做什么 |
|---|---|---|
| 刹车起点 | 均值150米,多数落在145到155米 | 估算自己能晚刹多少 |
| 刹车力度曲线 | 前段重刹、后段松得早 | 判断入弯速度与弯心位置 |
| 入弯线路 | 偏外侧进弯 | 预测内线是否留有空档 |
| 出弯油门 | 比理想时机晚约0.3秒 | 估算下一段直道的尾流机会 |
| 被紧跟时的变化 | 刹车点提前约10米 | 识别他的防守型刹车 |
最后一行最容易被忽略。很多玩家在后视镜里看到车以后会下意识提前刹车,这是被压迫时的行为,和平时的习惯不是一回事。系统如果把两种状态混成一个平均值,得到的是一个谁也不像的模型。雨天、轮胎磨损、换了车型之后的数据同理,都应该单独分桶,或者至少降低权重。
学会以后,对手最先改变的是超车窗口
假设AI驾驶的车在自身性能范围内可以在135米刹车并稳住车身,它就知道自己有约15米的晚刹空间,可以从内线切入。但如果策略层只做这一件事,结果会很难看:每一圈的第3弯,玩家都被同一种方式超车,比赛变成背答案。
模拟示例:一场5圈比赛里AI什么时候出手
第2圈,AI跟在玩家身后0.6秒,差距不够,不尝试。
第4圈,差距缩到0.3秒。AI判断:在第3弯晚刹能成功切入,但玩家出弯偏外,AI出弯后反而可能被他借尾流反超,于是选择不出手,而是贴紧跟出弯,等后面那条长直道。
第5圈,AI在长直道借尾流并排,利用玩家出弯油门偏晚的习惯,在下一个弯前完成超车。
这段过程里,AI没有变快,它只是把“能超”和“值得超”分开了。评估一次超车,至少要看成功率、出弯后被反超的风险、碰撞风险和剩余圈数。这才是学习玩家习惯带来的真正变化:决策的时机更准,而不是速度更高。
防守时,它会提前占住你习惯的那条线
反过来,当AI在前面、玩家在后面时,它学到的是玩家喜欢在哪里发起进攻。如果模型显示这位玩家八成的超车尝试都在第3弯内线,AI可以在直道末端提前向内移动半个车身。
防守动作需要规则约束。常见的赛车礼仪要求在刹车区不能反复变线,只允许一次明确的防守动作。公开资料显示,Sony AI与Polyphony Digital的GT Sophy研究(2022年登上Nature封面)在训练中专门设计了奖励项,让AI在高速对抗中遵守赛车礼仪。放到产品里的意思是:“学会封你的线”必须和“不做危险动作”绑在一起,否则学习型对手会变成一辆专门在刹车区别你的车。
学习边界:哪些信息AI不该碰
乐鱼体育在设计体育游戏智能对手时,把输入分成两类:
- 可以用:玩家车辆在赛道上的位置、速度、车身姿态、刹车灯亮起的时刻,以及历史圈里这些信息的统计。这些都是真人对手在赛道上能看到、能记住的东西。
- 不能用:玩家手柄的实时输入流,也就是车还没开始减速、刹车键刚被按下那一帧的信号;玩家的按键设置、辅助选项等界面信息;为了克制玩家而临时调高的抓地力、刹车性能或极速。
第一类让AI更像一个有经验的车手,第二类让它变成读心术加改装车。竞速游戏里的橡皮筋AI,也就是领先时对手加速、落后时对手减速,长期被批评为“一眼可见且不公平”,原因就在这里:玩家能感觉到规则在为某一方服务。
还有一个参照点。公开资料显示,Forza系列从2005年的初代就引入Drivatar学习玩家驾驶行为来生成对手;据AI and Games的分析,2023年的Forza Motorsport改为用深度强化学习从零训练驾驶网络,难度主要靠车辆性能分级来区分。即便在最经典的玩家建模案例里,“学习怎么开”和“车有多快”也是两套分开处理的东西。
哪里最容易学歪
- 样本太少:跑了3圈就断定玩家在150米刹车。一般至少需要同一弯道十几圈、而且情境相近的数据,才值得改变策略。
- 情境混淆:一场雨战里刹车全部提前,被当成了长期习惯。
- 过度拟合:AI算准了15米晚刹空间,玩家这一圈突然晚刹到130米,两车在弯心相撞。策略层需要在出手前做碰撞风险估计,预测偏差过大时退回通用超车逻辑。
- 忘不掉:玩家在进步,三周前的数据还按原权重计算。长期模型需要衰减机制,这部分在玩家行为模型里讨论过。
被读懂以后,玩家可以这样检查和反制
一个健康的学习型对手,应该让玩家能看懂、也能反过来学它。赛后可以按这个顺序检查:
- 打开复盘,找出每次被超车的位置,看它是否集中在同一两个弯。
- 对照自己在这些弯的刹车起点,看是不是长期固定在同一个距离。
- 下一场在这些弯刻意把刹车点前后变化10米左右,并在直道末端提前占内线。
- 观察AI是否在接下来几圈调整了出手位置。如果它跟着变了,说明它在学你;如果无论你怎么开它都一样“突然变快”,就该怀疑它在改数值,而不是在做决策。
最后一条也是乐鱼体育给学习型对手定的自检标准:每一次AI超车,复盘都应该能写出一句“它利用了你在第几弯的哪个习惯”。写不出来的超车,不该出现在一个标榜会学习的对手身上。