生成的速度一旦超过试玩的速度,测试就必须内置
设想一个模拟场景:某个周末,平台上的创作者生成了几百个3v3足球、街头篮球和卡丁车小游戏,每一个都只被作者本人玩过一两次。其中某个作品的球门被障碍物挡住一半,另一个作品的加时规则永远触发不了终场。如果这些问题只能等其他玩家打开后才暴露,UGC社区的信任会很快被消耗掉。
所以在生成式系统里,测试不是发布前的最后一道关,而是每次生成、每次修改后都要自动触发的环节。这就要求测试本身足够便宜、足够快,只能交给Agent来做。
行业走到这一步,大致经过了四种思路
公开资料里的代表性实践,可以按“测试Agent在替人做什么”来归类:
- 替设计师估难度。King 在 CIG 2018 的论文中,用玩家数据训练卷积网络,预测“最像人类”的操作,用来预估《Candy Crush》新关卡的难度。
- 替程序员提前查错。Ubisoft La Forge 在2018年介绍的 Commit Assistant 用约十年的代码历史训练,在提交前预测可能引入Bug的代码,官方称可发现约六成Bug,误报约三成。
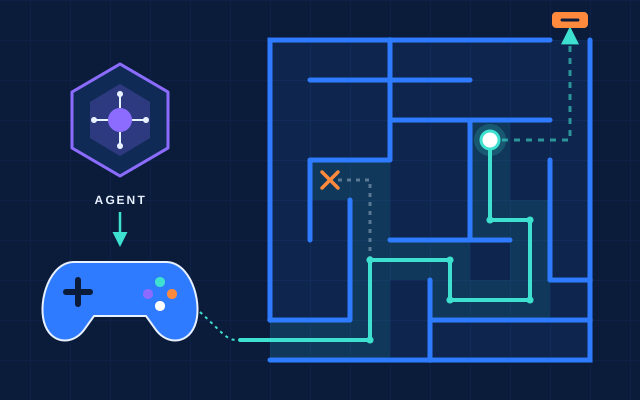
- 替测试员跑地图。EA SEED 在 IEEE CoG 2020 的论文中用深度强化学习提高测试覆盖率,发现漏洞和地图问题;2023年的另一篇论文专门讨论了在3A游戏里部署这类智能体的工程难题。
- 替测试员执行任务。2025年的 TITAN 研究用大模型智能体测试 MMORPG,作者自述任务完成率95%,发现了4个此前未知的Bug,并已部署到8条真实QA流水线。2026年 GDC 上,Razer 推出了自主试玩智能体加视觉Bug检测的 QA Companion-AI。
同一时期也有更冷静的数据。2026年4月发布的 GBQA 基准让大模型扮演QA工程师,最佳模型也只找出约48%的已验证Bug。测试Agent能大幅扩大覆盖面,但离“替代QA”还很远。
体育游戏里的Bug,应该按“谁能发现”来分类
通用游戏的Bug分类常按崩溃、画面、性能来划分。对生成式体育游戏,更实用的分法是看哪一类检查最先能抓住它,这决定了测试资源该往哪里放。下表示例均为模拟场景。
| Bug类型 | 模拟示例 | 最先能发现它的检查 |
|---|---|---|
| 结构错误 | 出生点落在墙体内,开球时球员被弹飞 | 静态验证,无需试玩 |
| 规则冲突 | 平局加时规则与赛制规则矛盾,比赛无法结束 | 规则引擎检查加少量试玩 |
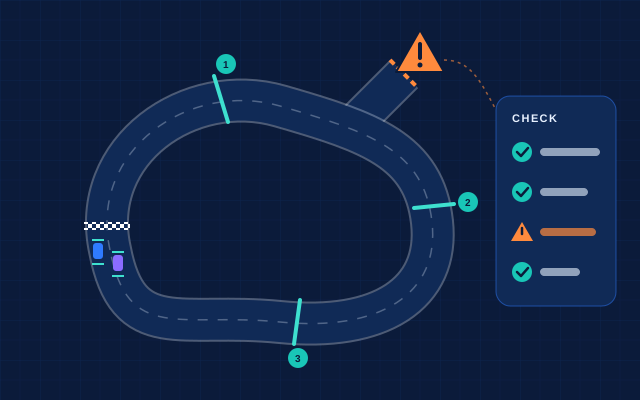
| 物理异常 | 球在路灯杆和墙之间反复弹跳,无法踢出 | 大量自动试玩统计球的停滞时间 |
| AI行为异常 | 对手AI在领先后集体退到门前不动 | 按比分情境分组的试玩 |
| 平衡问题 | 某一侧半场进球数明显偏高 | 多场试玩的分布对比 |
| 体验问题 | 雨天太滑,玩家觉得失控 | 只能靠真人反馈 |
最后一行是测试Agent目前最难覆盖的部分。“好不好玩”“手感对不对”仍然需要人来判断,Agent能做的是把前五类问题尽量在人看到之前处理掉。
体育比赛的覆盖率,不只是地图走没走到
在开放世界游戏里,覆盖率常指地图区域有没有被探索到。体育比赛的场地很小,真正需要覆盖的是比赛状态:领先、落后、平局,常规时间、加时、点球,球在前场、中场、后场,以及人数劣势等特殊情形。
以模拟的3v3足球为例,如果二十场自动试玩全部以一方领先结束,那么“平局进入金球”这条规则实际上一次都没被测到。一份合格的测试报告应该标出哪些规则分支被触发过、各触发了几次,而不是只给出“20场全部正常结束”。
Sports Game Agent在闭环里的四种分工
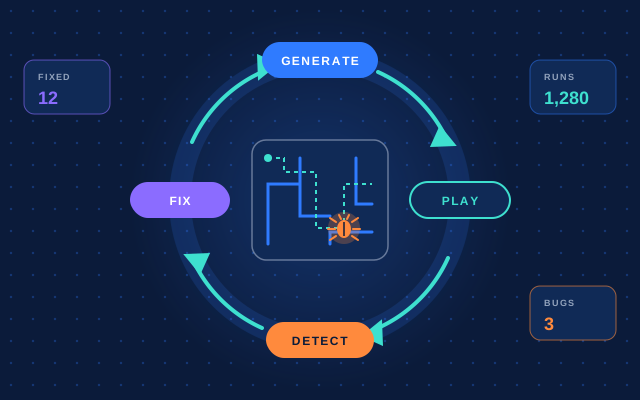
把测试接进生成流程后,形成的是 Generate → Play → Detect → Modify → Play Again 的循环。
在体育游戏里,Sports Game Agent 不是一个角色,而是几种分工:
- 规则探针:专门制造边界情形,比如故意把比分打平、故意把球踢出界,确认每条规则都能被触发且结果唯一。
- 物理探针:把球踢向角落、夹缝和障碍物背后,统计球和球员的停滞时间,定位卡死点。
- 风格模拟者:分别模拟偏好边路突破、偏好远射、偏好防守反击的玩家,检查比赛是否只对某一种打法友好。
- 平衡评估者:汇总多场结果,比较两侧半场、两支队伍、不同时间段的得分分布,找出异常倾斜。
这四种分工对应的正是自动游戏测试里“检测问题”这一步的具体内容。发现问题后,结构类和物理类问题通常可以自动修正,比如移动障碍物、调整出生点;规则类和平衡类问题则更适合生成修改建议,交给创作者确认。乐鱼体育的做法也是如此:自动修改只处理有明确正确答案的问题,涉及玩法取舍的问题一律让创作者拍板。
一份测试Agent报告至少应该回答这几件事
无论是平台还是创作者,在看自动测试结果时,都可以用下面这份清单判断报告是否可信:
- 跑了多少场,覆盖了哪些比分情形和规则分支,哪些分支从未触发。
- 发现的问题按上面的类型归类,每个问题附带可复现的场次或回放片段。
- 哪些问题已经自动修正,修正后是否重测,重测了多少场。
- 哪些问题只给出了建议,需要创作者决定。
- 明确写出哪些方面没有测,比如手感和观感,提醒创作者亲自试玩。
能回答完这五条的报告,才能作为作品是否进入AI体育游戏UGC社区的依据;只有一句“测试通过”的报告,信息量等于零。