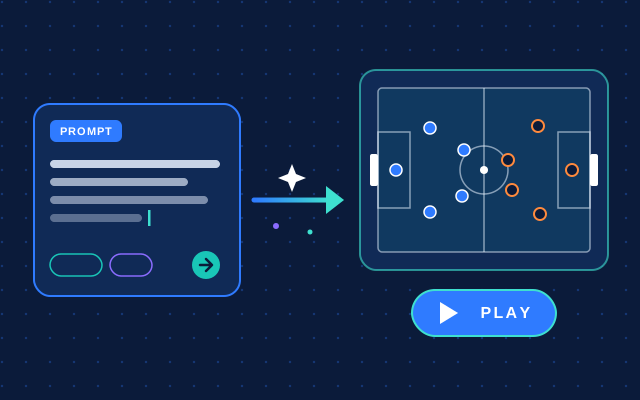
同一句话,可能产出两种完全不同的东西
先给出一个模拟示例,下文的场地尺寸、分数和时长都是为了说明问题而设定的,不是真实用户数据。玩家在创作框里写下:“雨天屋顶上的3v3篮球,11分制,输的一队下场,场边等着的一队上。”
第一种产物是素材包:一片带积水反光的屋顶,一个挂在铁架上的篮筐,九个穿着三种颜色背心的球员模型,雨丝从路灯下斜着落下来。截图发到社区,很有氛围。
第二种产物是一局比赛:玩家按下开始,控制红队的一名后卫运球,两名AI队友拉开空间,蓝队三名AI开始换防,玩家在弧顶外投进一球,记分牌跳成2比0,比赛一直打到某一队先拿到11分,蓝队输了走到场边,黄队上场,新的一局开始。
这两种产物在第一帧上可能长得一模一样。区别只有在玩家按下按键之后才会出现。下面这张表把这句话里的每个词拆开,看看素材层和游戏层分别要生成什么。
| 输入里的词 | 素材层要生成的 | 游戏层要生成的 |
|---|---|---|
| 雨天屋顶 | 屋顶模型、雨景、灯光、积水反光 | 场地边界、出界线、护栏碰撞、湿地面摩擦 |
| 3v3篮球 | 六名球员模型、篮球、篮筐 | 半场规则、进攻时限、谁由玩家控制、谁由AI控制 |
| 11分制 | 记分牌界面 | 每球算几分、先到11分即胜、是否设时间上限 |
| 输的一队下场 | 场边站着的第三支队伍 | 队伍队列、换队时机、出生点重置、下一局开始 |
右边一列没有一个是“画面”,却决定了这个东西能不能被称作游戏。
画面为什么反而是最容易生成的部分
公开资料显示,生成式模型在“看起来像在玩”这件事上进展很快。Google Research和DeepMind的GameNGen在2024年用扩散模型在单个TPU上以约20 FPS实时模拟DOOM;DeepMind在2025年8月发布的Genie 3可以从文字生成可实时导航的世界,720p、24 FPS,一致性能维持数分钟。微软发表在Nature上的Muse则被官方定位为玩法构思工具。
这些都是很有价值的研究,但它们本身的说明也指出了边界。Genie 3的官方局限里写着动作空间有限、多智能体交互较弱、时长只有数分钟。对体育游戏来说,“多智能体交互弱”几乎是致命的:一场3v3同时有六个行动主体,还有一个球在他们之间被传来传去,每一次触球都会改变比分和球权。
更关键的是容错度的差异。雨丝角度画错了,没有玩家会在意;三分弧线被生成在护栏外面,那就永远没人能投进两分球。画面错一点,玩家会宽容;规则错一点,比赛就打不下去。所以乐鱼体育在做一句话生成时,把画面放在流水线的后段,先确保规则、空间和循环是对的。
把一句话拆成八个必须回答的问题
一句话里通常只写出了两三个明确条件,其余全靠系统补全。补全得对不对,决定了第一局能否打完。
地图:边界在哪里,谁能走到哪里
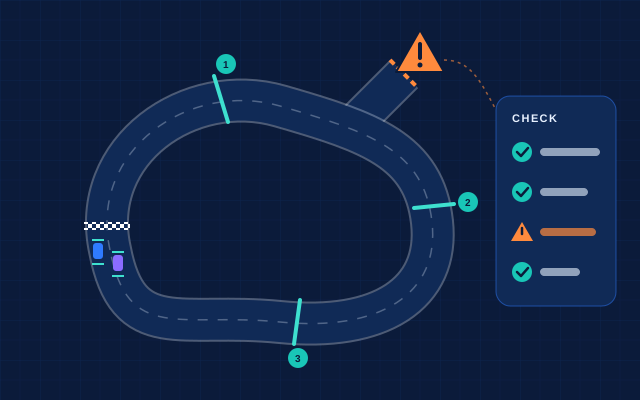
示例中的屋顶被设定为15米乘11米的半场,底线外只有0.8米就是护栏。空间模型要生成的不只是屋顶的样子,而是可行走区域、出界线、篮筐的精确位置和护栏的碰撞体。最常见的错误是护栏只有外观没有碰撞,球员追一个长篮板直接跑出屋顶。另一个常见错误是出界线画在了护栏外侧,球滚到护栏边上既不算出界也拿不回来,比赛卡住。
规则:“11分制”背后没写出来的条件
街头三人篮球常见的做法是弧内进球1分、弧外2分,但玩家并没有说。系统还要决定:防守方抢到篮板后是否需要把球带出弧外才能进攻,每回合有没有进攻时限,犯规怎么处理,得分后球权归谁,打到10比10要不要领先2分才算赢。规则引擎的做法是给每个未写明的条件填上默认值,然后在确认页上逐条列出来,让玩家决定是否修改,而不是悄悄替玩家做完所有决定。
玩家与输入:你到底在控制谁
3v3里玩家只控制一名球员,其余两名是AI队友。这就需要回答:开局默认控制哪一个位置,丢球后是否自动切换到离球最近的防守者,手柄上投篮是按键还是长按蓄力,触屏上传球是点人还是滑动方向。输入映射没定下来,再好的画面也只能看不能玩。
AI:另外五个人在做什么
没有AI,画面上的五名球员只是摆件。两名队友要会拉开空间、给出接球点、在玩家突破时补位;三名对手要会换防、协防和抢篮板。更容易被忽略的是,AI必须读取规则,而不是把规则写死在自己的行为里。如果规则要求抢到防守篮板后先带出弧外,AI就要知道这一点,否则它会在篮下直接补篮,然后被判进球无效。
得分与胜负:谁来数分,什么时候停
得分必须由物理结果触发:球从上往下穿过篮筐内的判定区域才算进。雨天场地往往会调高地面湿滑程度,也可能顺手改变球的反弹,如果判定区域没有区分方向,球从篮筐下方弹上去也可能被算成进球。胜负条件除了先到11分,还应该有一个时间上限,比如本例设定的10分钟,时间到则领先者胜,防止两个都不擅长进攻的AI队伍无限打下去。
Game Loop:这一局结束以后发生什么
“输的一队下场”是这句话里最有游戏感的部分,也是最复杂的部分。它是一个跨局规则:输队进入等待队列,队列最前面的队伍上场,出生点重置,比分清零,赢队的连胜计数加一。还有一个玩家没写的问题:如果玩家所在的红队输了,玩家是去场边等待,还是直接接管刚上场的黄队?两种设计都成立,但系统必须选一种,并在确认页上告诉玩家。
这条循环里任何一个环节断掉,玩家看到的都会是一个“生成成功”的画面,却打不完一局或开不了第二局。
最常见的几种“看起来生成成功了”
模拟案例:一局永远打不完的屋顶3v3
自动试玩时,蓝队AI抢到防守篮板后没有把球带出弧外,直接在篮下补进。规则引擎判定进球无效,球权交还红队;红队AI投篮不中,蓝队再次抢到篮板,再次篮下补进,再次被判无效。模拟跑满10分钟,比分停在3比2。
排查结果是:“带出弧外”这条规则存在于规则引擎里,但AI行为模块没有读取它,而是用了一套通用的篮球进攻逻辑。修复方式不是给AI单独打补丁,而是把规则条件作为AI决策的输入,以后玩家把这条规则关掉,AI也会自动跟着改变。
除了这种规则与AI脱节的情况,还有两类问题在模拟测试中出现频率很高:
- 比分能涨,比赛不结束:胜利条件读取的是一个变量,计分系统写入的是另一个变量,记分牌显示11比6,比赛仍在继续。
- 比赛能结束,下一局开不了:换队以后出生点仍按原队伍分配,黄队和红队出生在同一侧,开球后两队抢同一个篮筐。
这些问题的共同点是:单独看每个模块都没毛病,截图也没毛病,只有让比赛真正运行起来才会暴露。
生成之后,怎么证明它是一个游戏
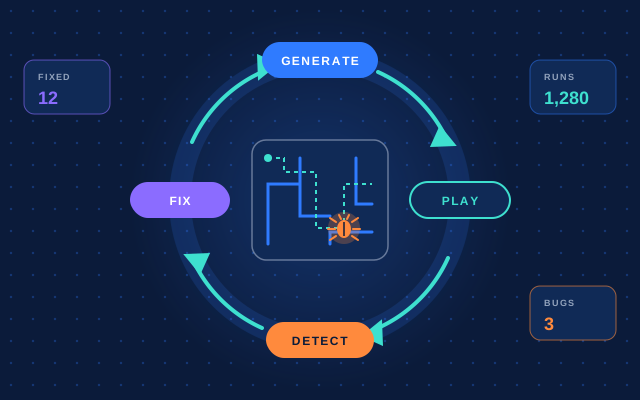
既然问题只有在运行时才出现,验证就必须让它运行。乐鱼体育的做法是在生成之后、交给玩家之前,先让测试代理在场上打若干局,也就是自动游戏测试。业界很早就有类似实践,King在2018年用模仿玩家操作的模型预测关卡难度,EA SEED在2020年用强化学习代理提高测试覆盖率。
测试代理跑完以后,系统看的不是画面,而是一组运行指标:
- 每局能正常结束的比例,以及平均时长是否落在合理区间。
- 得分分布:如果某一队八成得分都来自同一个位置,往往说明那里有地图漏洞或防守AI的盲区。
- AI卡住次数:球员长时间原地不动或贴着护栏来回跑。
- 换队后的第二局、第三局是否都能正确开球。
需要克制的一点是,自动测试不能替代人。2026年的GBQA基准显示,表现最好的模型也只找出约48%的已验证bug。所以测试代理的作用是挡住“打不完、开不了”这类硬问题,至于这一局好不好玩、节奏是不是太慢,仍然要交给玩家亲自试一局后判断。
玩家改一个词,系统应该重做哪几层
一句话生成的第一版很少是最终版。玩家试玩后可能会说:“改成7分制,每局限时5分钟。”这只涉及规则层和记分牌,地图、球员、AI站位都不该动。如果玩家说“把屋顶换成河边码头”,那么地图、碰撞、出界线和AI的默认站位都要重新生成,但11分制和换队规则可以原样保留。
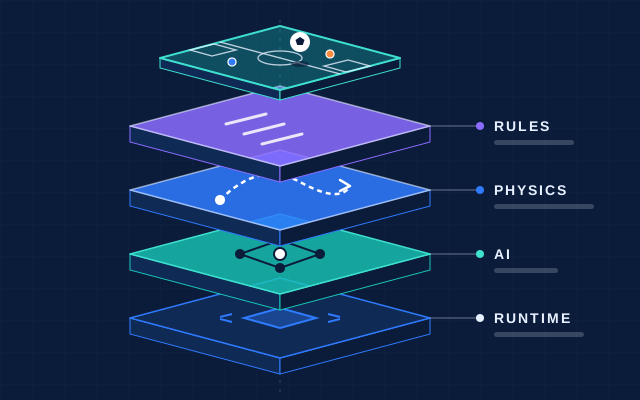
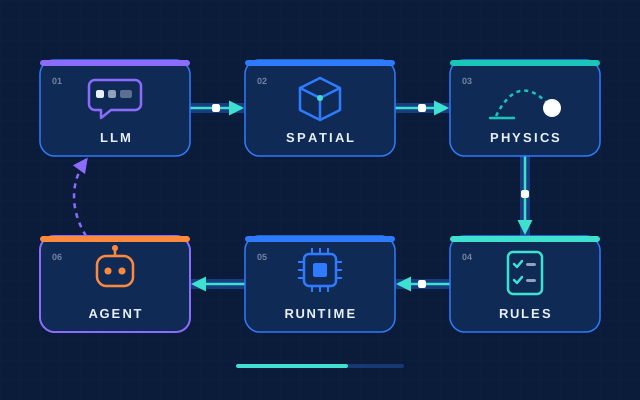
要做到这一点,系统必须记录每一个词影响了哪些层。理解“11分制”“输的一队下场”这些意图的,是文字大模型;把它们变成场地、碰撞体和可以运行的比赛的,是空间模型、物理引擎、规则引擎和运行时,这也是为什么一个文字大模型无法单独完成体育游戏生成。如果所有东西都由一次生成混在一起产出,玩家改一个词就只能整局推倒重来,之前调好的手感和AI行为也跟着丢失。
判断一次生成是否成功的五个问题
每次一句话生成完成后,可以按下面五个问题逐项检查:
- 开局时所有球员都站在场地内,而且每一名都有明确的控制者,玩家或AI?
- 至少有一种得分方式,玩家和AI都能真正触发?
- 比赛能在规则写明的条件下结束,并且有时间上限兜底?
- 结束后能进入下一局,换队、出生点重置、比分清零全部正确?
- 改一条规则时,只有和它相关的那几层被重新生成?
五个问题里有任何一个答不上来,这次生成得到的就还只是一组体育素材,而不是一个体育游戏。